

مدل جدید مایکروسافت برای تبدیل لحظهای صدا به متن با پشتیبانی از ۶۰ زبان معرفی شد
مدلهای هوش مصنوعی جدید مایکروسافت برای رونویسی بلادرنگ از صحبتهای گوینده طراحی شدهاند.

در دیجیاتو ثبتنام کنید
جهت بهرهمندی و دسترسی به امکانات ویژه و بخشهای مختلف در دیجیاتو عضو ویژه دیجیاتو شوید.
عضویت در دیجیاتو
مایکروسافت ماه گذشته MAI-Transcribe-2 را معرفی کرد که در آزمایشهای این شرکت توانست عملکرد بهتری از مدلهای رقیب OpenAI و گوگل در زمینه رونویسی ارائه دهد و هزینه استفاده از آن تنها ۰.۱۰ دلار به ازای هر ساعت بود.
این غول فناوری حالا مدل هوش مصنوعی صوتی MAI-Transcribe-2-Streaming را معرفی کرد؛ در کنار آن دو مدل جدید دیگر نیز معرفی شدند: MAI-Voice-2.1 و MAI-Voice-2.1-Flash. این مدلهای جدید برای همکاری با یکدیگر و کارکرد بهعنوان دستیارهای صوتی مکالمهای با تأخیر بسیار کم طراحی شدهاند.
مدل جدید صوتی مایکروسافت برای تبدیل صدا به متن
برخلاف MAI-Transcribe-2 که فقط فایلهای صوتی ضبطشده را پردازش میکند، مدل MAI-Transcribe-2-Streaming برای کاربردهای بلادرنگ طراحی شده است. این مدل بهجای اینکه تا پایان صحبت گوینده منتظر بماند و سپس متن را ارائه کند، کمی بیش از ۱۰۰ میلیثانیه پس از دریافت صدا شروع به تولید بخشهای اولیه متن میکند. مدل با دریافت اطلاعات بیشتر، این نتایج را بهطور مداوم اصلاح میکند تا در نهایت متن نهایی را ثبت کند.
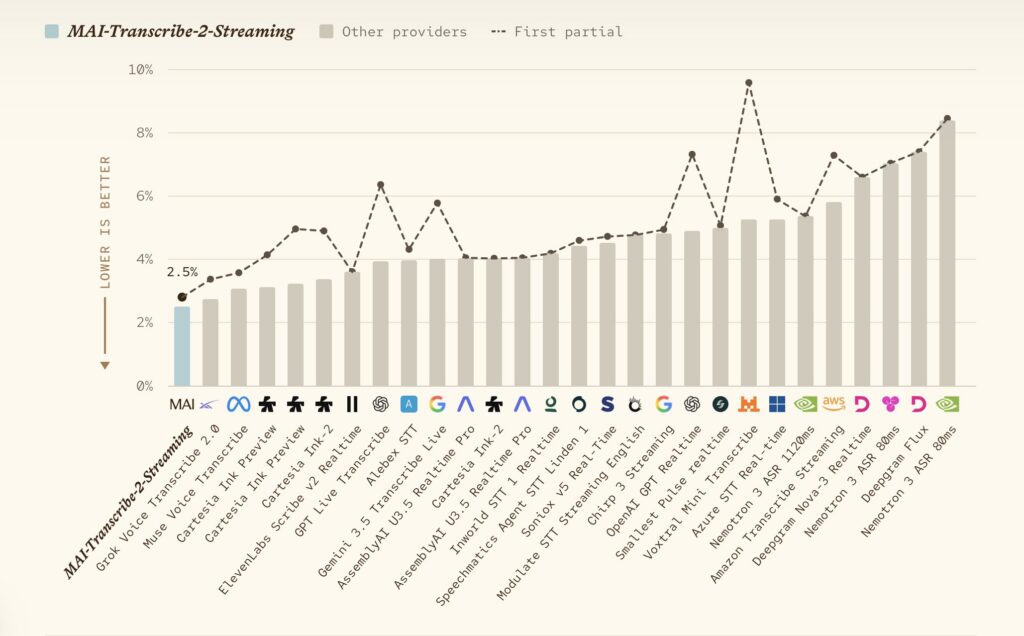
MAI-Transcribe-2-Streaming از ۶۰ زبان و تشخیص خودکار و مداوم زبان پشتیبانی میکند. مایکروسافت میگوید این مدل از نظر دقت متنهای اولیه و نهایی، در رتبه اول Artificial Analysis قرار گرفته است. در آزمایشهای داخلی مایکروسافت برای دیکته و زیرنویس، کلمات با این مدل دو برابر سریعتر از نزدیکترین رقیب در متن ظاهر شدند.
قیمت استفاده از این مدل تا پایان سال ۲۰۲۶، حدود ۰.۵۴ دلار به ازای هر ساعت فایل صوتی است. این رقم بهمراتب بیشتر از قیمت ۰.۱۰ دلار به ازای هر ساعت برای نسخه غیر Streaming یعنی MAI-Transcribe-2 است.
مایکروسافت همچنین مدل MAI-Voice-2.1 را معرفی کرد که جدیدترین مدل چندزبانه تبدیل متن به گفتار این شرکت محسوب میشود. مایکروسافت اوایل امسال MAI-Voice-2 و نسخه سریعتر آن، یعنی MAI-Voice-2-Flash، را معرفی کرده بود که در Dynamics 365 Contact Center و Azure Voice Live استفاده میشوند.MAI-Voice-2.1 از ۲۳ زبان در ۲۶ منطقه زبانی پشتیبانی میکند و هزینه آن ۲۲ دلار به ازای هر یک میلیون کاراکتر است.
برای کاربردهایی که به تأخیر کم و حجم بالای پردازش نیاز دارند، مایکروسافت MAI-Voice-2.1-Flash را نیز معرفی کرده است. این مدل میتواند ۴۵ ثانیه فایل صوتی را با حدود ۱۵۰ میلیثانیه تأخیر از ابتدا تا انتها تولید کند. مایکروسافت ادعا میکند این مدل ۵۵ درصد استنتاج سریعتری دارد و حدود ۶۰ درصد ارزانتر از مدلهای مشابه است. همچنین هزینه استفاده از آن ۱۵ دلار به ازای هر یک میلیون کاراکتر خواهد بود. هر دو مدل جدید صوتی همچنین امکان کلونکردن صدا را در زبانهای تحت پشتیبانی خود، تنها با استفاده از چند ثانیه صدای مرجع، دارند.




برای گفتگو با کاربران ثبت نام کنید یا وارد حساب کاربری خود شوید.