

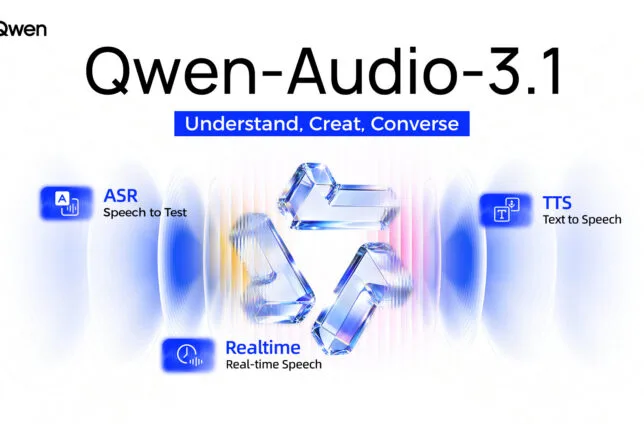
علیبابا از مدلهای Qwen-Audio-3.1 برای درک صوتی و مکالمه لحظهای رونمایی کرد
قیمت برخی از مدلهای این سری تا ۹۵ درصد کاهش یافته است.

علیبابا از نسل جدید مدلهای صوتی خود با نام Qwen-Audio-3.1 پرده برداشت؛ این مدلها قابلیتهای تشخیص گفتار، تبدیل متن به گفتار و تعامل صوتی لحظهای دارند.
مجموعه Qwen-Audio-3.1 شامل پنج مدل میشود که کاربرد آنها در حوزههای درک صدا، تولید گفتار، تعامل صوتی و ساخت محتوای صوتی است. علیبابا همچنین اعلام کرده قیمت استفاده از مدلها کمتر از نسخههای قبلی است؛ قیمت مدل TTS (متن به گفتار) حدود ۷۰ درصد، تعامل لحظهای حدود ۸۵ درصد و ASR تا ۹۵ درصد کاهش پیدا کرده است.
مدلهای صوتی جدید Qwen-Audio-3.1 علیبابا
مدل تشخیص گفتار ASR، شناسایی زبانها و گویشهای مختلف را بهبود میدهد. این مدل همچنین میتواند بهصورت خودکار کلمات پرکننده، تکرارها و بخشهای اضافی گفتار را حذف کند تا متن خروجی منسجمتر باشد.
مدل جدید ASR-Next علاوهبر تبدیل گفتار به متن، برای درک محتوای صوتی طراحی شده است. این مدل میتواند گفتوگوی چندنفره را تشخیص دهد و برای هر گوینده برچسب، زمانبندی و متن همتراز ارائه کند.
ASR-Next همچنین قادر است احساسات و صداهای محیطی و ماشینها را تشخیص دهد. این قابلیتها برای مواردی مانند توضیح محتوای صوتی، تعیین زمان رخدادهای صوتی، پرسشوپاسخ درباره صدا و استدلال مبتنی بر محتوای صوتی در نظر گرفته شدهاند.
مدل TTS برای تبدیل متن به گفتار، از زبانها و گویشهای مختلف پشتیبانی میکند و امکان انتقال طبیعی صدا میان زبانهای مختلف را فراهم میکند. کاربران میتوانند با دستورهای متنی، ویژگیهایی مانند احساس، سرعت و سبک صحبت کردن را کنترل کنند.
مدل Qwen-Audio-3.1-TTS از ۱۶ زبان و ۲۰ گویش چینی پشتیبانی میکند که هفت زبان در این نسخه جدید اضافه شدهاند. مدل میتواند متنهای پیچیده از نظر تبدیل نوشتار به گفتار را پردازش کند و در یک مرحله، محتوای صوتی طولانی تا سه دقیقه بسازد. این مدل همچنین برای کار با نمونههای صوتی نامناسب، نویزدار، دارای انعکاس یا نامفهوم طراحی شده و به حالت جداگانهای برای حذف نویز نیاز ندارد.
مدل Realtime نیز برای مکالمه صوتی طراحی شده و میتواند همزمان به صحبت کاربر گوش و پاسخ دهد. این مدل امکان قطع کردن صحبت و ادامه مکالمه در هر لحظه را فراهم میکند تا تعامل صوتی به مکالمه تلفنی نزدیکتر شود. طبق توضیحات علیبابا، این مدل حتی میتواند در صورت تشخیص حال نامناسب کاربر، سرعت پاسخگویی خود را کاهش دهد و با لحنی همدلانهتر صحبت کند.




برای گفتگو با کاربران ثبت نام کنید یا وارد حساب کاربری خود شوید.