

گوگل با قابلیت جدیدی سرعت مدلهای Gemma 4 را تا سه برابر افزایش میدهد
قابلیت جدید مدلهای Gemma 4 کیفیت خروجی را کاهش نمیدهد و مصرف باتری را نیز بهینه میکند.

در دیجیاتو ثبتنام کنید
جهت بهرهمندی و دسترسی به امکانات ویژه و بخشهای مختلف در دیجیاتو عضو ویژه دیجیاتو شوید.
عضویت در دیجیاتوتازههای تکنولوژی


گوگل بهار امسال مدلهای متنباز Gemma 4 را منتشر کرد که برای اجرای آفلاین روی گوشی و کامپیوتر بسیار مناسب هستند. اکنون گوگل با قابلیت جدید «پیشبینی چندتوکنی» (MTP) این مدلها را سریعتر از قبل کرده است. گوگل میگوید این مدلهای آزمایشی میتوانند چند توکن آتی را پیشبینی کنند که در مقایسه با روش قدیمیتر مدلهای عادی، سرعت تولید متن تا سه برابر بیشتر خواهد شد.
یکی از بزرگترین موانع در اجرای مدلهای محلی، محدودیت پهنای باند حافظه در سیستمهای معمولی است. اکثر سیستمهای خانگی فاقد حافظههای HBM موجود در سرورها هستند و زمان زیادی از چرخه پردازنده صرف انتقال دادهها از حافظه گرافیکی به واحدهای محاسباتی میشود. مدلهای زبانی بهطور معمول به روش خودبازگشتی عمل میکنند و برای هر توکن، فارغ از میزان پیچیدگی آن، توان پردازشی یکسانی را مصرف میکنند. تکنولوژی MTP با یک مفسر سبکوزن (مانند نسخه E2B با ۷۴ میلیون پارامتر) از زمانهای تلفشده پردازنده بهره میبرد و توکنهای آینده را پیشبینی میکند. درواقع این مفسرها با استفاده از حافظه KV Cache مشترک با مدل اصلی، از محاسبات تکراری جلوگیری میکند.
در این فرایند، توکنهای پیشبینیشده توسط مفسر بهصورت موازی با مدل اصلی تأیید میشوند. اگر پیشبینیها درست باشد، کل توالی در یک عملیات واحد پذیرفته میشود که این امر منجر به افزایش چشمگیر کارایی میگردد.
افزایش سرعت مدلهای Gemma 4 با ویژگی جدید
فناوری اصلی مدلهای Gemma 4 مستقیماً از هوش مصنوعی پیشرفته جمینای الهام گرفته شده است، با این تفاوت که برخلاف جمینای که برای اجرا در خوشههای بزرگ دیتاسنتر و تراشههای اختصاصی TPU گوگل بهینهشده، Gemma برای اجرا روی دستگاههای کاربران تنظیم شده است.
درحالیکه جمینای از پهنای باند فوقسریع و حافظههای اختصاصی بهره میبرد، مدلهای Gemma به گونهای طراحی شدهاند که حتی بزرگترین نسخههای آنها با دقت کامل روی یک شتابدهنده هوش مصنوعی تکی اجرا شوند. همچنین با استفاده از فرایند کوانتایزکردن، امکان اجرای این مدلهای قدرتمند روی پردازشگرهای گرافیکی معمولی و خانگی فراهم شده است تا کاربران بتوانند بدون نیاز به ارسال دادههای خصوصی خود به فضاهای ابری، از قدرت هوش مصنوعی روی سختافزار شخصیشان استفاده کنند.
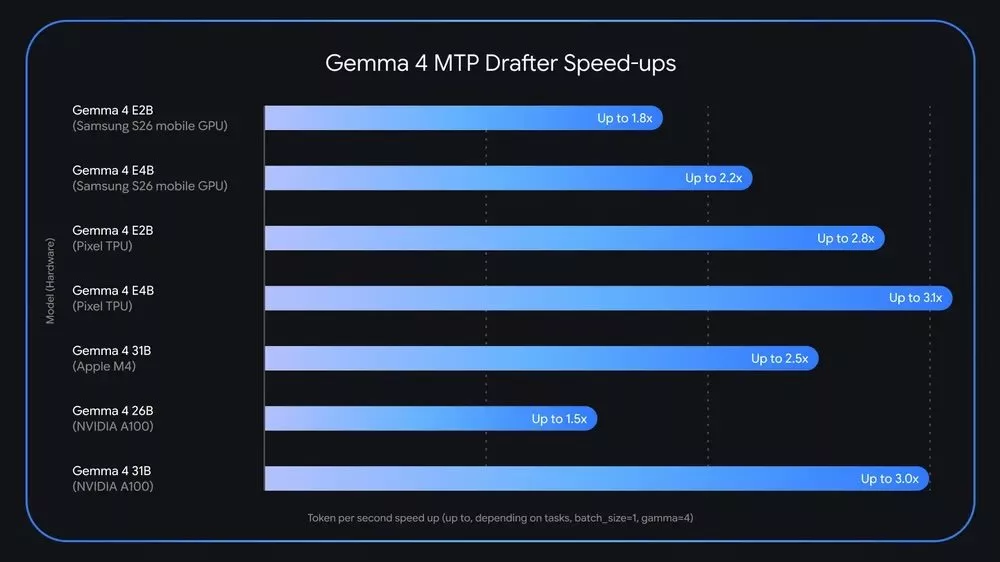
طبق دادههای گوگل، این روش هیچگونه افت کیفیتی در خروجی نهایی ایجاد نمیکند، زیرا تمامی نتایج توسط هسته اصلی مدل راستیآزمایی میشوند. این بهینهسازی در آزمایشهای عملی خیرهکننده بوده است؛ بهطوریکه سرعت اجرا در گوشیهای پیکسل برای مدلهای E2B و E4B به ترتیب ۲.۸ و ۳.۱ برابر افزایش یافته و مدل ۳۱ میلیاردی Gemma 4 روی تراشههای M4 اپل نیز بهبود سرعتی معادل ۲.۵ برابر را تجربه کرده است.
علاوهبر سرعت، استفاده از MTP منجر به بهبود طول عمر باتری در دستگاههای موبایل و سهولت اجرای مدلهای سنگینتری مانند 26B MoE و 31B Dense روی سختافزارهای مختلف شده است. گوگل همچنین با تغییر مجوز این مدلها به Apache 2.0، دست توسعهدهندگان را برای استفاده گستردهتر و آزادانهتر باز گذاشته است. کاربران میتوانند این مدلهای ارتقایافته را در پلفترمهایی مانند SGLang و Ollama تست کنند.


مقالات و اخبار مرتبط


برای گفتگو با کاربران ثبت نام کنید یا وارد حساب کاربری خود شوید.


اگه میخواین مدلای جما4 رو تست کنید با اینترانت هم میشه : تو سایت p30download سرچ کنید Ollama یا LM Studio که مدل جدید جما 4 رو دارن ، حالا جاهای دیگه و لینک های دیگه هم هست !
آیا جما تصویر هم می سازه ، مثل نانو بنانا؟
نه، باید از مدلهای تولید تصویر استفاده کرد (flux, z-image, sdxl,...)
ممنون که جواب دادی
من خودم Gemma 3 4b دارم.
امیدوارم اینترنت باز بشه که بتونم Gemma 4رو سیستم تست کنم😔🙏
Ai_src در بله میتونی دانلود کنی
"در این فرایند، توکنهای پیشبینیشده توسط مفسر بهصورت موازی با مدل اصلی تأیید میشوند. اگر پیشبینیها درست باشد، کل توالی در یک عملیات واحد پذیرفته میشود که این امر منجر به افزایش چشمگیر کارایی میگردد."
یه سوال. این احیانا همون speculative decoding نیست؟ اگه باشه که مختص gemma نیست
بله، مکانیسم اصلی همون Speculative Decoding هستش که مفهومی جدید هم توی دنیای LLMها نیست. اما اونجوی که گوگل گفته، اینجا توی جما Speculative Decoding با Multi-Token Prediction ترکیب شده و مقدار توکندرثانیه رو بیشتر کرده.
درسته، ممنون🙏
مینوایل ما هم تو ایران با سرعت عجیبی به عصر حجر برمیگردیم
امروز دیدم قهوه کیلویی ۵ تومن به بالا شده. سرعت بالاست. قهوه هم داره لاکچری میشه
قهوه که هیچی الان دیگه تخم مرغ هم لاکچریه
اتفاقا تخم مرغ دونه ای ۱۵ تومن یعنی وعده ای ۳۰ تومن، هنوز برای جیره بندی گزینه خوبیه! البته لوبیا پخته یا عدسی بهتره
هعی روزگار 69 و فکنم برسه به 70 وصل نشه میشیم کشوری که به اضافه گرونی و افسردگی قطعی اینترنت هم بهش اضافه شد
رکورد بدبخت ترین کشور کل تاریخ
that's Amazing 😍👌
ممنون از نویسنده این مطلب . بسیار تشکر می کنم